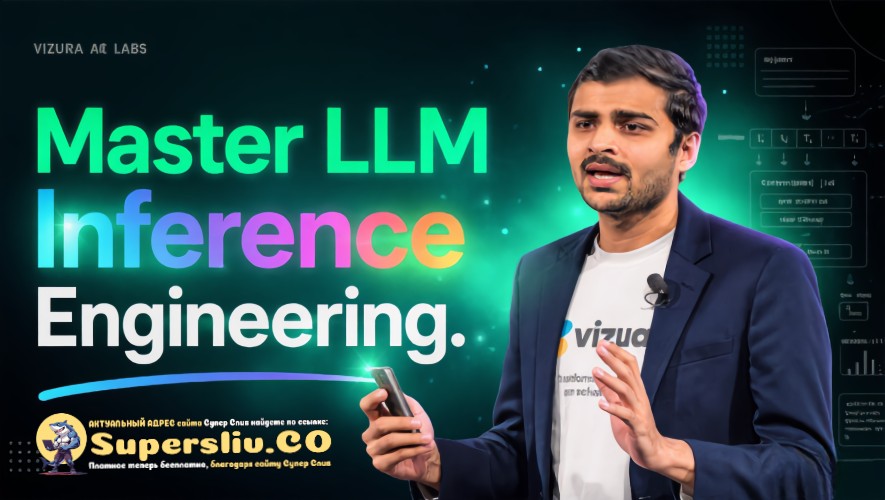
«Профессиональный инференс LLM» — практический четырехнедельный интенсив для тех, кто хочет разобраться, как
запускать, оптимизировать и масштабировать большие языковые модели в реальных production-системах. Курс охватывает полный путь: от фундаментальных принципов инференса и работы GPU-памяти до распределенного развертывания, edge-инференса, квантизации, профилирования и построения высокопроизводительных AI-сервисов, способных обслуживать большие объемы запросов с низкой задержкой.
О курсе
Курс посвящен профессиональному инференсу больших языковых моделей: тому, как LLM работают после обучения, как они обрабатывают запросы пользователей, почему возникают задержки, как повысить пропускную способность сервера и какие инженерные решения используются в современных AI-компаниях.
Программа объединяет теорию, лабораторные работы, живые демонстрации и практику на реальном оборудовании. Занятия проводят доктор Радж Дандекар, MIT PhD, а также инженеры и специалисты из Anthropic, NVIDIA, Apple, Microsoft, Amazon, AnyScale и других технологических компаний.
Чему вы научитесь
- Понимать архитектуру современных систем инференса LLM и ключевые этапы обработки запроса.
- Оптимизировать производительность больших языковых моделей по задержке, пропускной способности и использованию GPU.
- Работать с памятью GPU, KV cache, механизмами внимания и ограничениями аппаратных платформ.
- Применять квантизацию моделей для ускорения инференса и снижения потребления ресурсов.
- Использовать популярные фреймворки и инструменты: vLLM, SGLang, FlashAttention, TensorRT-LLM, Ray Serve и Megatron-LM.
- Развертывать LLM на локальном компьютере, сервере, Raspberry Pi 4, Android-устройстве и NVIDIA Jetson Orin Nano.
- Проектировать production-ready AI-сервисы с масштабируемой архитектурой.
- Готовиться к техническим собеседованиям, где проверяют понимание системного дизайна LLM-инференса.
Структура программы
Курс состоит из двух самостоятельных модулей. Первый модуль фокусируется на принципах и оптимизации инференса, второй — на промышленном развертывании и построении прикладных AI-систем.
Модуль 1. Архитектура и оптимизация инференса LLM
В первой части вы изучите, как устроен инференс больших языковых моделей, какие узкие места возникают при обработке запросов и как современные фреймворки помогают повысить эффективность работы моделей.
- Основы инференса LLM и жизненный цикл запроса.
- Prefill, decode, batching и continuous batching.
- KV cache и оптимизация использования памяти.
- Механизмы внимания и FlashAttention.
- Квантизация моделей и компромиссы между скоростью, качеством и потреблением памяти.
- Профилирование производительности и поиск bottleneck-компонентов.
- Практическая работа с vLLM, SGLang, TensorRT-LLM и другими инструментами.
Модуль 2. Production-развертывание и edge-инференс
Во второй части курса вы перейдете от оптимизации отдельных моделей к созданию полноценных AI-сервисов, которые можно использовать в реальных продуктах и инфраструктуре.
- Промышленное развертывание LLM-сервисов.
- Распределенные вычисления и масштабирование инференса.
- Ray Serve и подходы к обслуживанию большого числа запросов.
- Edge-инференс на компактных устройствах.
- Запуск моделей на Raspberry Pi 4, Android и NVIDIA Jetson Orin Nano.
- Сравнение аппаратных платформ и анализ производительности.
- Построение надежных production-ready AI-приложений.
Практика и лабораторные работы
Большая часть курса построена вокруг практических заданий. Каждый учебный день сопровождается лабораторными работами в Google Colab, визуальными материалами, демонстрациями и разбором инженерных решений.
Вы будете не только изучать теорию, но и запускать модели, измерять их производительность, анализировать использование ресурсов, сравнивать разные конфигурации и применять методы оптимизации на практике.
Оборудование и платформы
- Локальный компьютер для базового запуска и тестирования моделей.
- Google Colab для лабораторных работ и экспериментов.
- Raspberry Pi 4 для изучения ограничений edge-инференса.
- Android-устройство для запуска LLM на мобильной платформе.
- NVIDIA Jetson Orin Nano для практики с компактным GPU-ускорителем.
Итоговые проекты
В рамках курса вы реализуете два полноценных проекта, которые помогут закрепить навыки разработки и оптимизации систем инференса LLM.
Проект 1. Высокопроизводительный сервер инференса LLM
Вы пройдете полный путь от исходных весов модели до оптимизированного сервиса инференса. В процессе вы настроите запуск модели, проведете профилирование, выявите узкие места, примените техники ускорения и подготовите систему к обработке реальных запросов.
- Загрузка и подготовка модели.
- Настройка сервера инференса.
- Оптимизация latency и throughput.
- Анализ производительности каждого компонента.
- Подготовка сервиса к production-сценариям.
Проект 2. AI-помощник для WhatsApp
Второй проект посвящен созданию интеллектуального AI-помощника для WhatsApp. Он будет обрабатывать диалоги, генерировать ответы и улучшать свое поведение с помощью обучения с подкреплением на основе пользовательских взаимодействий.
- Интеграция LLM с чат-интерфейсом.
- Разработка логики AI-ассистента.
- Использование диалогов для улучшения качества ответов.
- Применение подходов reinforcement learning в прикладном сценарии.
Инструменты и технологии
Во время обучения вы познакомитесь с современным стеком инструментов, который используется для ускорения и масштабирования инференса больших языковых моделей.
- vLLM — высокопроизводительный inference engine для обслуживания LLM.
- SGLang — фреймворк для эффективного выполнения LLM-приложений.
- FlashAttention — оптимизированные механизмы внимания для ускорения работы трансформеров.
- TensorRT-LLM — инструменты NVIDIA для оптимизации инференса больших моделей.
- Ray Serve — решение для масштабируемого serving-а AI-моделей.
- Megatron-LM — фреймворк для работы с крупными языковыми моделями и распределенными вычислениями.
- Google Colab — среда для лабораторных работ и экспериментов.
Для кого подойдет курс
- ML-инженерам, которые хотят глубже разобраться в оптимизации и развертывании LLM.
- Backend- и infrastructure-инженерам, работающим с AI-сервисами и высоконагруженными системами.
- Data scientists, которые хотят перейти от экспериментов с моделями к production-разработке.
- AI-разработчикам, создающим чат-ботов, ассистентов и LLM-приложения.
- Техническим специалистам, готовящимся к собеседованиям в AI-компании.
- Основателям и техническим лидерам, которым нужно понимать стоимость, ограничения и архитектуру LLM-инференса.
Какие результаты вы получите
После прохождения курса вы сможете проектировать и внедрять системы инференса LLM, которые учитывают требования к скорости, стоимости, масштабируемости и надежности.
- Понимание внутренних механизмов работы LLM во время инференса.
- Навык оптимизации моделей под разные аппаратные платформы.
- Опыт работы с industry-standard инструментами для LLM serving.
- Умение проводить профилирование и принимать инженерные решения на основе метрик.
- Два практических проекта для портфолио.
- Более уверенная подготовка к техническим интервью по LLM-инфраструктуре.
Почему стоит изучать инференс LLM
Разработка больших языковых моделей — это не только обучение нейросетей. В реальных продуктах основная стоимость и сложность часто связаны именно с инференсом: скоростью ответов, нагрузкой на GPU, масштабированием, потреблением памяти и стабильностью сервиса.
Специалисты, которые понимают, как эффективно обслуживать LLM в production, востребованы в командах, создающих AI-ассистентов, корпоративные чат-боты, агентные системы, поисковые продукты, инструменты для разработчиков и другие приложения на базе генеративного искусственного интеллекта.
Язык Английский
ИСТОЧНИК
СКАЧАТЬ