Главная » Программирование » Vizuara AI Labs - Dr. Sreedath Panat → Малые языковые модели (SLM): полный процесс создания и внедре
Vizuara AI Labs - Dr. Sreedath Panat → Малые языковые модели (SLM): полный процесс создания и внедре

5 б
Облако Mail
179 P
Артикул: 17158
В наличии
Автор курса: Vizuara AI Labs
Категория: Программирование
Дата выхода: 2026
Продажник от автора: Перейти
Описание
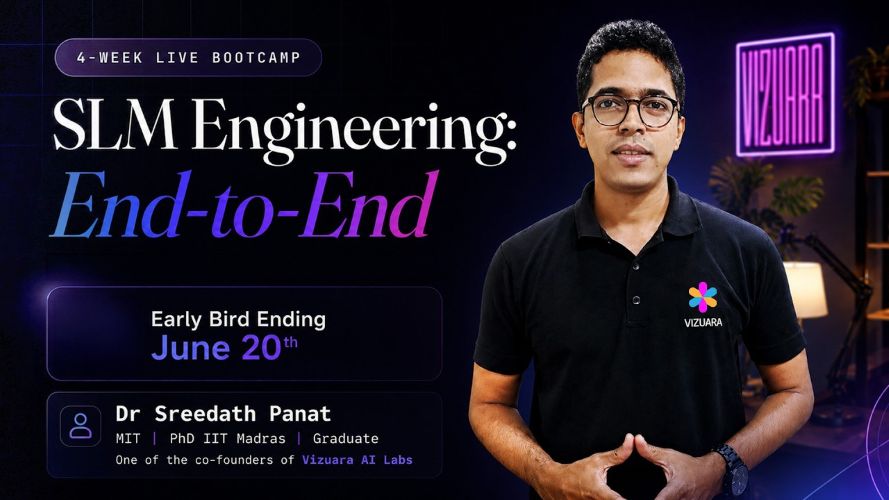
SLM Engineering — практический курс по созданию малых языковых моделей (Small Language Models, SLM) корпоративного уровня. За четыре недели вы пройдете полный цикл разработки: от подготовки данных и обучения токенизатора до предварительного обучения (Pretraining), Fine-Tuning, RLHF, реализации RAG, оптимизации инференса и развертывания модели в локальной инфраструктуре предприятия. Курс ориентирован на разработчиков и ML-инженеров, желающих самостоятельно создавать, обучать и внедрять современные AI-системы без зависимости от облачных сервисов.
Для кого предназначен курс
Архитектура Transformer
Подробно изучите внутреннее устройство современных языковых моделей: механизм внимания (Attention), Feed Forward-блоки, RMSNorm, Rotary Positional Encoding, эмбеддинги и взаимодействие всех компонентов архитектуры Transformer.
Подготовка данных и обучение токенизатора
Научитесь собирать, очищать и дедуплицировать датасеты, формировать корпуса данных, обучать собственные токенизаторы на основе BPE и SentencePiece, а также готовить данные для предварительного обучения и последующей настройки моделей.
Предварительное обучение (Pretraining)
Построите полноценный цикл обучения языковой модели с нуля, познакомитесь с законами масштабирования (Scaling Laws), научитесь анализировать функции потерь и оценивать эффективность процесса обучения.
Fine-Tuning с LoRA и QLoRA
Освоите современные методы параметроэффективной настройки моделей, включая LoRA, QLoRA, Supervised Fine-Tuning и 4-битную квантизацию. Узнаете, в каких случаях лучше использовать дообучение модели, а когда предпочтительнее применять RAG или инженерный подход к проектированию промптов.
Выравнивание моделей и безопасность
Изучите методы Reward Modeling, DPO и RLHF, научитесь реализовывать защиту от Prompt Injection, механизмы безопасных отказов, модерацию ответов и другие элементы безопасной эксплуатации языковых моделей.
RAG и оценка качества моделей
Создадите полноценную систему Retrieval-Augmented Generation с гибридным поиском, ранжированием результатов, ссылками на источники и использованием подходов LLM-as-a-Judge и Golden Sets для оценки качества моделей.
Инференс и оптимизация производительности
Разберетесь с особенностями работы этапов Prefill и Decode, использованием KV Cache, квантизацией моделей, Continuous Batching, Paged Attention и развертыванием высокопроизводительных серверов инференса на базе vLLM и llama.cpp.
Развертывание в продакшене
Научитесь создавать API для языковых моделей, организовывать потоковую обработку запросов, внедрять мониторинг, отслеживание деградации качества моделей, Canary-развертывания и автоматический цикл повторного обучения.
Полный цикл разработки SLM
Во время обучения вы реализуете полный производственный конвейер создания корпоративной языковой модели:
Финальной работой станет разработка корпоративного помощника для анализа юридических договоров. Вы создадите собственную малую языковую модель, которая сможет автоматически извлекать и классифицировать положения договоров, обнаруживать персональные данные и конфиденциальную информацию, выполнять поиск по документам с точными ссылками на соответствующие разделы и работать полностью локально без передачи данных в облачные сервисы.
Результаты обучения
После завершения курса вы сможете самостоятельно проектировать, обучать, оптимизировать и внедрять Small Language Models (SLM) корпоративного уровня. Вы получите практический опыт работы с Transformer, LoRA, QLoRA, RLHF, RAG, vLLM, llama.cpp, промышленными AI-конвейерами и современными инструментами разработки LLM, а также пополните портфолио полноценным проектом, готовым к использованию в реальных корпоративных сценариях.
Язык Английский
ИСТОЧНИК
СКАЧАТЬ
Для кого предназначен курс
- Разработчиков, переходящих в сферу LLM Engineering, NLP и Enterprise AI.
- Инженеров, создающих чат-ботов, интеллектуальный поиск и системы анализа документов.
- Специалистов, которые хотят научиться самостоятельно обучать языковые модели, а не только использовать готовые API.
- Исследователей, которым необходимы практические навыки промышленной разработки AI.
Архитектура Transformer
Подробно изучите внутреннее устройство современных языковых моделей: механизм внимания (Attention), Feed Forward-блоки, RMSNorm, Rotary Positional Encoding, эмбеддинги и взаимодействие всех компонентов архитектуры Transformer.
Подготовка данных и обучение токенизатора
Научитесь собирать, очищать и дедуплицировать датасеты, формировать корпуса данных, обучать собственные токенизаторы на основе BPE и SentencePiece, а также готовить данные для предварительного обучения и последующей настройки моделей.
Предварительное обучение (Pretraining)
Построите полноценный цикл обучения языковой модели с нуля, познакомитесь с законами масштабирования (Scaling Laws), научитесь анализировать функции потерь и оценивать эффективность процесса обучения.
Fine-Tuning с LoRA и QLoRA
Освоите современные методы параметроэффективной настройки моделей, включая LoRA, QLoRA, Supervised Fine-Tuning и 4-битную квантизацию. Узнаете, в каких случаях лучше использовать дообучение модели, а когда предпочтительнее применять RAG или инженерный подход к проектированию промптов.
Выравнивание моделей и безопасность
Изучите методы Reward Modeling, DPO и RLHF, научитесь реализовывать защиту от Prompt Injection, механизмы безопасных отказов, модерацию ответов и другие элементы безопасной эксплуатации языковых моделей.
RAG и оценка качества моделей
Создадите полноценную систему Retrieval-Augmented Generation с гибридным поиском, ранжированием результатов, ссылками на источники и использованием подходов LLM-as-a-Judge и Golden Sets для оценки качества моделей.
Инференс и оптимизация производительности
Разберетесь с особенностями работы этапов Prefill и Decode, использованием KV Cache, квантизацией моделей, Continuous Batching, Paged Attention и развертыванием высокопроизводительных серверов инференса на базе vLLM и llama.cpp.
Развертывание в продакшене
Научитесь создавать API для языковых моделей, организовывать потоковую обработку запросов, внедрять мониторинг, отслеживание деградации качества моделей, Canary-развертывания и автоматический цикл повторного обучения.
Полный цикл разработки SLM
Во время обучения вы реализуете полный производственный конвейер создания корпоративной языковой модели:
- сбор и подготовка данных;
- обучение токенизатора;
- создание эмбеддингов;
- обучение Transformer-модели;
- предварительное обучение;
- Fine-Tuning и RLHF;
- реализация RAG;
- оптимизация инференса;
- развертывание модели в корпоративной инфраструктуре.
Финальной работой станет разработка корпоративного помощника для анализа юридических договоров. Вы создадите собственную малую языковую модель, которая сможет автоматически извлекать и классифицировать положения договоров, обнаруживать персональные данные и конфиденциальную информацию, выполнять поиск по документам с точными ссылками на соответствующие разделы и работать полностью локально без передачи данных в облачные сервисы.
Результаты обучения
После завершения курса вы сможете самостоятельно проектировать, обучать, оптимизировать и внедрять Small Language Models (SLM) корпоративного уровня. Вы получите практический опыт работы с Transformer, LoRA, QLoRA, RLHF, RAG, vLLM, llama.cpp, промышленными AI-конвейерами и современными инструментами разработки LLM, а также пополните портфолио полноценным проектом, готовым к использованию в реальных корпоративных сценариях.
Язык Английский
ИСТОЧНИК
СКАЧАТЬ
Страница посвящена обучающему материалу «Vizuara AI Labs - Dr. Sreedath Panat → Малые языковые модели (SLM): полный процесс создания и внедре», доступному в каталоге Sklads.net.
Год выпуска курса — 2026.
В нашем каталоге курс доступен за 179 рублей.
Материал относится к категории «Программирование».
Другие курсы автора «Vizuara AI Labs» можно найти по имени через поиск Sklads.net.
✅ После оплаты система мгновенно направит на вашу почту ссылку(и) на курс, регистрация необязательна!
🛑 Авторизуйтесь или зарегистрируйтесь и Вы получите ссылку не только на почту, но и на странице товара.
📲 Наши отзывы на сайте | в Telegram (кликабельно)
🤔 Есть сомнения в инфопродукте? В качестве гарантии можем отправить дополнительные скриншоты, любой видео файл или сделать запись с экрана содержимого на облаке.
🔆 Нашли дешевле в другом месте? Сделаем цену ещё ниже чем там где вы нашли!
✍🏻 По всем вопросам, в том числе с оплатой и получением - писать в Telegram (кликабельно), в чат на сайте (в нижнем правом углу) или на почту admin@coursx.net Мы всегда на связи!
Поделиться страницей
Также смотрите
Vizuara AI Labs - Dr. Rajat Dandekar → Master LLM Inference (Phase 1: Foundations & Optimization)Владимир Елфимов - LLM Driven Development Разработка и эксплуатация AIDr. Sreedath Panat → Создание голосовых AI / Vizuara AI Labs - агентов с нуляLLM / Gigaschool - инженеStepik / Станислав Попов - LLM для Python-разработчиков: от RAG до агентов
Часто задаваемые вопросы о складчинах
Что такое складчина?
Складчина — это совместная покупка обучающего материала несколькими участниками. Благодаря этому стоимость курса распределяется между покупателями, и итоговая цена получается значительно ниже предложения автора.
Почему цена ниже, чем на официальном сайте?
Материалы приобретаются совместно, поэтому вам не нужно оплачивать полную авторскую стоимость. На странице товара может быть указана цена оригинального предложения, чтобы вы могли сравнить её со стоимостью на Sklads.net.
Что входит в комплект материалов?
Обычно в комплект входят записи уроков, дополнительные файлы, инструкции, презентации, таблицы и другие материалы, предусмотренные программой курса. Точный состав зависит от конкретного товара и указывается в его описании.
Как я получу доступ после оплаты?
После подтверждения оплаты ссылка на материалы автоматически отправляется на указанную электронную почту. Если вы вошли в аккаунт перед покупкой, ссылка также может быть доступна непосредственно на странице товара.
Можно ли проверить наличие курса до покупки?
Да. По запросу мы можем предоставить подтверждение наличия материалов: дополнительные скриншоты, запись экрана, пример файла или фрагмент одного из уроков.
Что делать, если курс был обновлён автором?
Если у нас появляется новая версия материала, информация об обновлении может быть указана на странице товара. По вопросам актуальности конкретного курса можно обратиться в поддержку перед покупкой.
На какой срок предоставляется доступ?
Доступ к материалам предоставляется без ограничения по времени, пока ссылка остаётся активной. Для надёжности рекомендуем сохранить материалы на своё устройство или личное облако после получения.
Возможен ли возврат средств?
Возврат возможен, если после оплаты вы не получили доступ к приобретённому материалу и проблема не была устранена поддержкой.
Другие складчины
Быстрая доставка
Гарантируем быструю доставку заказа на ваш Email.
Лучшие цены
Гарантируем самые низкие цены. Сделаем цену ниже если нашли дешевле.
Прием заказов 24/7
Заказы принимаются круглосуточно!
100% Безопасная оплата
Безопасная оплата и получение заказа.